Claude Fable 5.2 wyznacza nowe standardy sztucznej inteligencji
9 listopada 2026 roku firma Anthropic zaprezentowała Claude Fable 5.2 oraz Claude Mythos 5.2, nową generację zaawansowanych modeli sztucznej inteligencji przeznaczonych do rozwiązywania szczególnie wymagających problemów technicznych i naukowych. Najnowszy Fable oferuje znacznie większą skuteczność w programowaniu, analizie złożonych systemów, automatyzacji i wieloetapowym rozumowaniu. Według wyników przedstawionych przez producenta model wyprzedza Fable 5.1, Opus 5.5 oraz konkurencyjne rozwiązania OpenAI i Google w wielu istotnych benchmarkach. Jednocześnie poprawiono efektywność przetwarzania i obniżono ceny API. Premiera wskazuje na rosnące znaczenie systemów AI zdolnych do samodzielnego planowania, wykonywania i weryfikowania skomplikowanych zadań.
Większy kontekst i inteligentne zarządzanie rozumowaniem
Claude Fable 5.2 wykorzystuje okno kontekstowe o pojemności do miliona tokenów oraz maksymalną odpowiedź wynoszącą 128 tysięcy tokenów. Obsługuje tekst i obrazy na wejściu, natomiast wyniki generuje w postaci tekstowej. Istotną funkcją jest Adaptive Thinking, czyli automatyczne dostosowywanie intensywności rozumowania do charakteru problemu. Mechanizm pozostaje aktywny przez cały czas, a poziom effort określa głębokość analizy. Dzięki temu możliwe jest przetwarzanie obszernych repozytoriów, dokumentacji technicznej, wyników testów i zależności między komponentami. Rozbudowany kontekst nie oznacza jednak trwałej pamięci całego projektu ani jednakowych limitów we wszystkich aplikacjach korzystających z modelu.
Wyraźny wzrost skuteczności względem poprzedniej generacji
Porównanie z Fable 5.1 pokazuje istotny postęp w zadaniach wymagających autonomicznego działania i wielokrotnego sprawdzania rezultatów. W FrontierCode 2.0 wynik wzrósł z 32,4% do 49,1%, natomiast w FrontierSWE v2 z 56,3% do 69,9%. Jeszcze większą poprawę odnotowano w RoboDojo Sim, gdzie skuteczność zwiększyła się z 27,6% do 64,9%. W AutomationBench osiągnięto 51,4% wobec wcześniejszych 31,4%, a w Chartography 73,4% zamiast 44,8%. Anthropic deklaruje również generowanie odpowiedzi nawet o 30% szybciej oraz bardziej efektywne wykorzystanie tokenów rozumowania. Wyniki pochodzą z testów producenta i nie stanowią gwarancji analogicznego przyspieszenia we wszystkich rzeczywistych projektach.
Rywalizacja z OpenAI i Google nabiera tempa
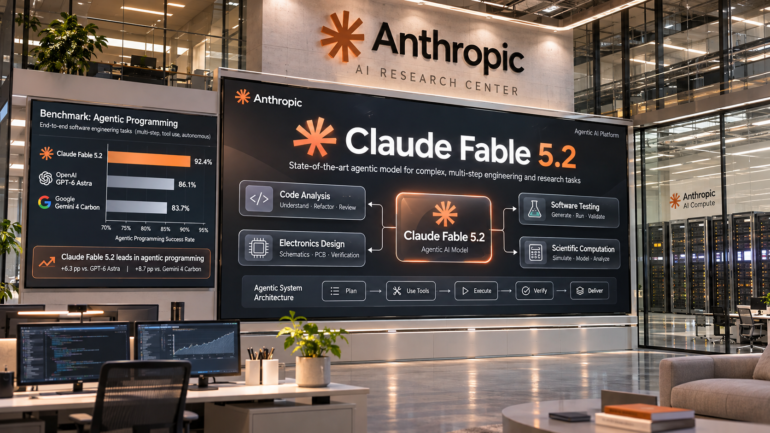
W opublikowanych zestawieniach Fable 5.2 uzyskał 49,1% w FrontierCode 2.0, wyprzedzając Opus 5.5 z wynikiem 45,5%, GPT-6 Astra z 42,8% oraz Gemini 4 Carbon z 41,1%. W FrontierSWE v2 nowy model Anthropic osiągnął 69,9%, podczas gdy GPT-6 Astra uzyskał 65,5%, a Gemini 4 Carbon 61,2%. Podobną przewagę odnotowano w Terminal-Bench-Science oraz testach zaawansowanego rozumowania. Nie wszystkie kategorie zostały jednak zdominowane przez Anthropic. W AutomationBench prowadzi Gemini 4 Carbon z wynikiem 53,9%, wobec 51,4% uzyskanych przez Fable 5.2. Porównania wykorzystują różne konfiguracje effort i nie zawsze identyczne warunki pomiarowe, dlatego nie przesądzają o bezwzględnej dominacji jednego modelu we wszystkich zastosowaniach.
Nowa pozycja Fable w rodzinie Claude
Anthropic utrzymuje wyraźny podział zastosowań pomiędzy swoimi modelami. Claude Opus 5.5 pozostaje rekomendowanym rozwiązaniem do codziennej, wymagającej pracy, natomiast Fable 5.2 jest przeznaczony do problemów przekraczających możliwości standardowych modeli. Sonnet 5.5 zapewnia równowagę pomiędzy skutecznością, szybkością i kosztami, a Haiku 5.5 obsługuje prostsze operacje realizowane na dużą skalę. W przypadku Fable szczególne znaczenie mają długotrwałe procesy agentowe, analiza architektury oraz rozwiązywanie problemów wymagających zmiany strategii podczas pracy. Nowa wersja kosztuje 8 USD za milion tokenów wejściowych i 40 USD za milion tokenów wyjściowych, czyli o 20% mniej niż Fable 5.1. Mimo wyższej ceny jednostkowej od Opusa, bardziej efektywne wykonywanie niektórych zadań może ograniczać całkowity koszt ich realizacji.
Zaawansowane programowanie agentowe w Cursor IDE
Claude Fable 5.2 został udostępniony również w Cursor IDE, gdzie obsługuje narzędzia agentowe, edycję kodu, analizowanie repozytoriów, wykonywanie poleceń terminala i weryfikowanie wyników testów. Standardowy kontekst wynosi 300 tysięcy tokenów, natomiast maksymalny może osiągnąć milion. Dostępne ustawienia effort obejmują Low, Medium, High, Extra High oraz Max. Poziom High stanowi zalecany punkt początkowy dla wymagających zadań inżynierskich, a Extra High i Max mogą być wykorzystywane przy szczególnie trudnych problemach architektonicznych lub badawczych. Model sprawdza się przede wszystkim przy wielomodułowych refaktoryzacjach, skomplikowanych migracjach, analizie regresji i krytycznym code review. Jego wykorzystanie nie eliminuje jednak konieczności niezależnej kontroli zmian, testowania oprogramowania i zatwierdzania integracji.
Ekonomia pracy z wieloma modelami AI
W środowisku Cursor koszt Fable 5.2 pozostaje zauważalnie wyższy niż w przypadku modeli przeznaczonych do rutynowego programowania. Grok 4.7 Standard kosztuje 2 USD za milion tokenów wejściowych i 6 USD za milion wyjściowych, natomiast Composer 2.5 Standard odpowiednio 0,50 USD i 2,50 USD. Oznacza to, że wykorzystywanie Fable do każdej drobnej poprawki byłoby zazwyczaj nieuzasadnione ekonomicznie. Bardziej racjonalne jest rozdzielenie pracy pomiędzy modele wykonawcze oraz wyspecjalizowany model analityczny. Fable może odpowiadać za diagnozowanie skomplikowanego problemu i planowanie rozwiązania, a Grok lub Composer za jego przewidywalną implementację. W starszych planach Cursor modele Anthropic wykorzystują pulę Other Models, co dodatkowo wpływa na opłacalność intensywnego korzystania z najdroższych wariantów.
Autonomiczne systemy i formalna weryfikacja matematyczna
Możliwości nowego modelu przedstawiono również w eksperymentach wykraczających poza standardowe generowanie kodu. Według Anthropic Fable 5.2 koordynował ponad tysiąc subagentów podczas ośmiodniowej pracy nad prototypowym systemem operacyjnym, obejmującym między innymi jądro, sterowniki, system plików i interfejs okienkowy. W innym projekcie uczestniczył w migracji usługi z Pythona do Rusta, uzyskując około 26-krotne przyspieszenie jej uruchamiania. Szczególne znaczenie miała demonstracja matematyczna, w której zespół około tysiąca agentów sformalizował istniejący dowód wielkiego twierdzenia Fermata w Lean w ciągu 30 godzin. Nie oznaczało to odkrycia nowego dowodu, lecz zapisanie i zweryfikowanie znanego rozumowania w formalnym systemie. Eksperymenty wskazują na potencjał skalowania pracy agentowej, chociaż ich rezultaty wymagają odróżnienia od gotowych, produkcyjnych rozwiązań.
Od projektowania elektroniki do badań fizycznych
Rozwój Fable 5.2 obejmuje również zastosowania związane ze światem fizycznym. We współpracy z firmą Diode model opracował projekty trzech działających urządzeń elektronicznych, uwzględniające komponenty, czterowarstwowe płytki PCB, obudowy i oprogramowanie. Według producenta urządzenia uruchomiono bez konieczności wprowadzania elektrycznych poprawek do wyprodukowanych płytek. Poprawiono także wyniki w RoboDojo Sim, badającym zdolności związane ze sterowaniem robotami. Anthropic przedstawiło ponadto rezultaty prac dotyczących dwóch otwartych problemów fizyki czarnych dziur, wymagające dalszej oceny naukowej. Przykłady pokazują rozszerzanie zastosowań AI z generowania treści na projektowanie, analizę i weryfikację rzeczywistych systemów technicznych. Nie należy jednak utożsamiać demonstracji badawczych z pełną niezawodnością w warunkach przemysłowych.
Cyberbezpieczeństwo i ograniczenia przetwarzania danych
Claude Fable 5.2 oraz Claude Mythos 5.2 korzystają z tej samej podstawowej architektury, lecz różnią się zasadami dostępu i zabezpieczeniami. Fable jest dostępny szeroko, natomiast Mythos przeznaczono dla zweryfikowanych organizacji realizujących szczególnie wrażliwe zadania badawcze i związane z cyberbezpieczeństwem. Istotnym ograniczeniem standardowego korzystania z Fable pozostaje polityka retencji danych. Anthropic przewiduje przechowywanie danych wejściowych i wyjściowych przez 30 dni na potrzeby monitorowania bezpieczeństwa, z określonymi wyjątkami. W zespołach Cursor korzystających z Privacy Mode aktywacja modelu może wymagać zaakceptowania dodatkowych warunków dotyczących retencji danych. Z tego powodu organizacje pracujące z poufnym kodem powinny analizować warunki prywatności niezależnie od skuteczności modelu w benchmarkach.
Od asystenta programowania do autonomicznego inżyniera
Premiera Fable 5.2 pokazuje stopniowe przesuwanie granic możliwości systemów sztucznej inteligencji. Najważniejszym kierunkiem rozwoju staje się samodzielne realizowanie kompletnych procesów inżynierskich, zamiast generowania pojedynczych fragmentów kodu. Nowe modele potrafią planować działania, korzystać z narzędzi, koordynować agentów pomocniczych, analizować niepowodzenia i modyfikować własne strategie. Rosnąca autonomia nie oznacza jednak wyeliminowania odpowiedzialności człowieka za bezpieczeństwo, architekturę i końcową jakość rozwiązania. W praktyce najbardziej prawdopodobny staje się model współpracy, w którym AI wykonuje coraz większą część pracy technicznej, a nadzór człowieka koncentruje się na wymaganiach, ograniczeniach i ocenie rezultatów.


