GPT-6 Sol wchodzi między najmocniejsze modele AI
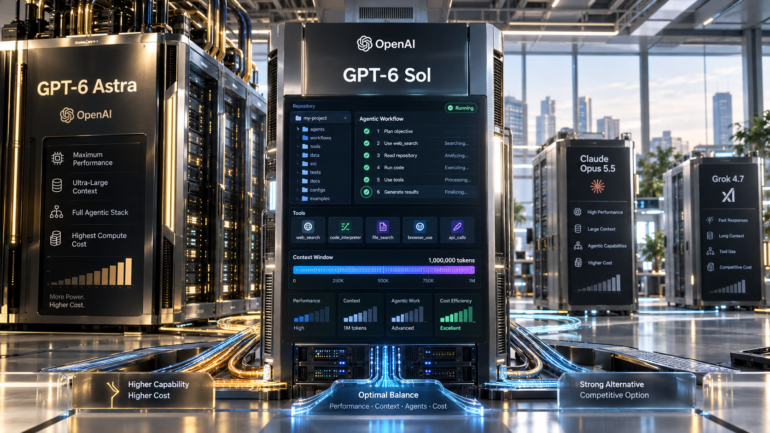
OpenAI rozszerzyło rodzinę modeli o model GPT-6 Sol, zaprojektowany przede wszystkim do złożonego programowania, pracy agentowej oraz długich workflow. Nie zastępuje on flagowego GPT-6 Astra, lecz zajmuje miejsce pomiędzy najmocniejszym wariantem rodziny a znacznie lżejszym GPT-6 Luna. Najważniejszą cechą Sol staje się połączenie wysokiej jakości reasoning, dużego kontekstu i wyraźnie niższej ceny, dzięki czemu model może być stosowany częściej w codziennej pracy developerskiej.
Architektura przygotowana pod długie zadania
GPT-6 Sol został zbudowany z myślą o sytuacjach, w których model nie tylko odpowiada na pojedyncze pytanie, ale otrzymuje repozytorium, zestaw narzędzi i cel do wykonania. Obsługiwane są poziomy reasoning od none do max, ponad milion tokenów kontekstu oraz do 128 tysięcy tokenów wyjściowych. Dostępne są również function calling, web search, file search i computer use. Takie możliwości wskazują na wyraźne ukierunkowanie modelu na agentic workflows, automatyzację oraz wieloetapową pracę nad kodem.
Cena zmienia sposób wykorzystania modeli frontier
Najbardziej charakterystycznym elementem GPT-6 Sol jest jego pozycjonowanie cenowe. Standardowe API zostało wycenione na 2 dolary za milion tokenów wejściowych i 10 dolarów za milion tokenów wyjściowych, podczas gdy GPT-6 Astra kosztuje odpowiednio 10 i 50 dolarów. Oznacza to pięciokrotną różnicę przy każdym z tych parametrów. Sol nie musi więc osiągać identycznych wyników jak Astra, aby stać się atrakcyjnym modelem do regularnego programowania, refaktoryzacji, code review i automatyzacji.
Reasoning mocno wpływa na skuteczność
Wyniki Artificial Analysis pokazują, że skuteczność GPT-6 Sol wyraźnie zależy od wybranego poziomu reasoning. Artificial Analysis Intelligence Index rośnie od 34 punktów przy ustawieniu low do 48 punktów przy max, a jeszcze większe różnice widoczne są w zadaniach terminalowych. W Terminal-Bench 4.0 rezultat wzrasta od 9% przy low do 44% przy max. W praktyce oznacza to, że konfiguracja reasoning może zmieniać charakter pracy Sol na tyle mocno, jakby używano kilku różnych wariantów tego samego modelu.
Astra pozostaje modelem do najtrudniejszych problemów
GPT-6 Astra nadal osiąga wyższe wyniki w większości najbardziej wymagających testów. W maksymalnych konfiguracjach Astra uzyskuje 53 punkty Artificial Analysis Intelligence Index wobec 48 punktów GPT-6 Sol i zachowuje znaczną przewagę między innymi w Terminal-Bench oraz AutomationBench-AA. Sol potrafi jednak zbliżyć się do flagowego modelu, a w niektórych testach wypadać porównywalnie. Różnica polega więc przede wszystkim na kompromisie pomiędzy maksymalną skutecznością a kosztem regularnego wykorzystania.
Claude Opus 5.5 ustawia wyżej poprzeczkę
Znacznie trudniejszym punktem odniesienia okazuje się Claude Opus 5.5. W zestawieniu Artificial Analysis model Anthropic osiąga 58 punktów Intelligence Index wobec 48 punktów GPT-6 Sol i wyprzedza rozwiązanie OpenAI także w AutomationBench-AA, Terminal-Bench, SciCode oraz Humanity’s Last Exam. Jednocześnie kosztuje około dwukrotnie więcej za token. Opus 5.5 reprezentuje więc podejście nastawione na maksymalną skuteczność, natomiast Sol mocniej akcentuje relację możliwości do ceny.
Fable 5.1 traci przewagę ekonomiczną
Claude Fable 5.1 nadal zachowuje wysoką jakość i przewagę nad Sol w części benchmarków, ale jego pozycja stała się mniej oczywista. Przy cenie 10 dolarów za milion tokenów wejściowych i 50 dolarów za wyjściowe jest pięciokrotnie droższy od GPT-6 Sol. Jednocześnie na rynku pojawił się mocniejszy i tańszy Opus 5.5. Fable pozostaje rozwiązaniem do trudnych autonomicznych zadań, lecz nowe modele wywierają na niego presję zarówno od strony jakości, jak i kosztów.
Grok 4.7 oferuje inne podejście do agentic coding
W bezpośrednim zestawieniu z Grokiem 4.7 różnice nie są już jednostronne. GPT-6 Sol osiąga lepsze wyniki w części testów reasoning, terminalowych i naukowych, natomiast Grok 4.7 prowadzi w niektórych benchmarkach profesjonalnych i agentowych. Modele różnią się również zachowaniem podczas generowania odpowiedzi: Sol może generować tokeny szybciej, ale przy wysokim reasoning dłużej przygotowuje pierwszą odpowiedź. Grok 4.7 został natomiast silnie ukierunkowany na długie zadania wykonywane bezpośrednio w środowisku Cursor IDE.
Największe ograniczenie pojawia się w Cursor IDE
Możliwości GPT-6 Sol nie przekładają się jeszcze bezpośrednio na pełne wykorzystanie w Cursorze. Model nie znajduje się obecnie na oficjalnej liście natywnie obsługiwanych modeli Cursor IDE, podczas gdy dostępne są między innymi Grok 4.7, Claude Opus 5.5, Claude Fable 5.1 oraz Composer 2.5. Możliwe jest wykorzystanie modeli OpenAI przez własny klucz API lub rozszerzenie Codex IDE, ale nie zapewnia to identycznej integracji z natywnym Cursor Agent. Brakuje wówczas części zalet wynikających z pełnego harness, routingu, narzędzi, zarządzania kontekstem i mechanizmów właściwych dla Cursora.
Integracja może być ważniejsza niż sam benchmark
W praktyce pracy developerskiej najwyższy wynik modelu nie zawsze oznacza najlepsze doświadczenie. Cursor łączy modele z wyszukiwaniem repozytorium, terminalem, regułami projektu, narzędziami agentowymi, subagentami i mechanizmami wykonywania zmian. Dlatego model nieco słabszy w syntetycznym benchmarku może okazać się skuteczniejszy, jeżeli został lepiej zintegrowany z IDE. Z tego powodu Grok 4.7 oraz Claude Opus 5.5 pozostają obecnie bardziej naturalnymi rozwiązaniami dla wymagających workflow wykonywanych bezpośrednio w Cursorze.
Granica między modelem codziennym a eskalacyjnym zanika
Najważniejszym znaczeniem GPT-6 Sol nie jest zdobycie pierwszego miejsca we wszystkich rankingach. Model pokazuje, że zaawansowany reasoning, ogromny context window oraz obsługa agentic workflows mogą być oferowane znacznie taniej niż w dotychczasowych modelach frontier. Dotychczas naturalne było wykorzystywanie taniego modelu do większości pracy i bardzo drogiego rozwiązania tylko podczas eskalacji najtrudniejszych problemów. Sol zaczyna zmniejszać dystans pomiędzy tymi dwiema kategoriami i może umożliwić częstsze stosowanie zaawansowanego reasoning w zwykłym workflow developerskim.


