Claude Opus 5.5 zmienia układ modeli AI
Premiera Claude Opus 5.5 wyraźnie zmieniła sytuację wśród modeli przeznaczonych do programowania agentowego. Nowy model Anthropic został zoptymalizowany pod długie operacje na repozytoriach, migracje wielu plików, refaktoryzacje, code review, pracę z terminalem, narzędziami i subagentami. Według danych producenta odpowiedzi są generowane szybciej niż w Opus 5, przy jednoczesnym ograniczeniu zużycia tokenów i kosztu realizacji zadania. Oznacza to, że znaczenie nowej wersji nie wynika wyłącznie ze wzrostu jakości, ale również z poprawy efektywności ekonomicznej podczas rozbudowanych workflow programistycznych.
Więcej możliwości przy niższych kosztach
Claude Opus 5.5 został wyceniony niżej od poprzedniej generacji, a szczególnie duża różnica dotyczy odczytu danych z cache. Standardowe stawki API wynoszą 4 dolary za milion tokenów wejściowych oraz 20 dolarów za milion tokenów wyjściowych, podczas gdy Opus 5 kosztował odpowiednio 5 i 25 dolarów. W agentowym development cache ma istotne znaczenie, ponieważ podczas kolejnych operacji wielokrotnie wykorzystywane są te same fragmenty repozytorium oraz wcześniejszego kontekstu. Połączenie wyższej wydajności z niższą ceną sprawia więc, że model może być wykorzystywany częściej niż poprzedni Opus bez równie dużego wzrostu kosztów.
CursorBench pokazuje dużą zmianę generacyjną
Różnicę między generacjami szczególnie dobrze widać w CursorBench 4.0, który obejmuje zadania związane między innymi z edycją wielu plików, refaktoryzacją i długą pracą agentową. Opus 5.5 osiąga 57,8% w trybie Max, 56,0% w High i 52,5% w Medium, podczas gdy Opus 5 Max uzyskuje 46,6%. Oznacza to, że nawet wariant Medium nowego modelu osiąga wyższy rezultat niż najmocniejsza konfiguracja poprzednika. Pokazuje to również, że maksymalny poziom reasoning nie zawsze musi być potrzebny do uzyskania wysokiej jakości rozwiązania.
Fable 5.1 przestaje być oczywistą eskalacją
Najbardziej interesujące jest porównanie z Claude Fable 5.1, który był projektowany pod długie, autonomiczne i wieloetapowe zadania. W CursorBench 4.0 Opus 5.5 Medium osiąga 52,5% przy średnim koszcie około 2,91 dolara na zadanie, natomiast Fable 5.1 Max uzyskuje 51,8% przy koszcie około 17,28 dolara. Różnica cenowa występuje również na poziomie tokenów, ponieważ Fable kosztuje około 2,5 raza więcej za input i output. Nie oznacza to utraty znaczenia Fable, ale sprawia, że jego użycie staje się bardziej specjalistyczne zamiast automatycznego traktowania go jako ostatniego stopnia każdej eskalacji.
Opus 5.5 wyprzedza Groka w zadaniach Cursora
Grok 4.7 pozostaje modelem nastawionym na dłuższą pracę agentową i jest znacznie tańszy, jednak jego wyniki w CursorBench są niższe. Grok 4.7 osiąga 46,3% w Extra High, 43,9% w High i 41,6% w Medium, podczas gdy Opus 5.5 zaczyna od 52,5% w Medium i dochodzi do 57,8% w Max. Grok zachowuje jednak ważną przewagę praktyczną: kosztuje mniej i w Cursorze należy do puli Cursor Models. Dzięki temu może nadal pełnić rolę modelu pośredniego pomiędzy tanim Composerem a znacznie mocniejszym Opusem.
Konkurencja nie znika z pola widzenia
Porównania z pozostałymi modelami pokazują, że Opus 5.5 nie dominuje jednak absolutnie w każdym rodzaju zadania. W testach agentowego programowania i pracy terminalowej wypada bardzo mocno, ale GPT-6 Astra zachowuje przewagę w wybranych benchmarkach związanych z automatyzacją i zastosowaniami naukowymi. Podobnie rezultat GPT-5.6 Sol w CursorBench jest niższy, lecz sam benchmark mierzy przede wszystkim scenariusze pochodzące z pracy agentowej w Cursor IDE. Wyniki należy więc interpretować w kontekście konkretnego zastosowania, a nie jako uniwersalny ranking wszystkich możliwości modeli.
Model przygotowany bezpośrednio do pracy agentowej
W Cursor IDE Claude Opus 5.5 może korzystać z wyszukiwania plików, edycji kodu, terminala, przeglądarki, reguł projektu oraz subagentów. Standardowe okno kontekstowe wynosi 300 tysięcy tokenów, a maksymalnie może zostać zwiększone do miliona tokenów bez osobnego mnożnika ceny za przekroczenie podstawowego limitu. Cursor rekomenduje High Thinking jako konfigurację zapewniającą najlepsze rezultaty. Dostępny jest również Fast Mode, jednak podwaja on koszt tokenów, dlatego jego wykorzystanie jest najbardziej uzasadnione wtedy, gdy szybkość odpowiedzi jest ważniejsza niż ekonomia pracy.
Nowa drabina eskalacji w Cursor IDE
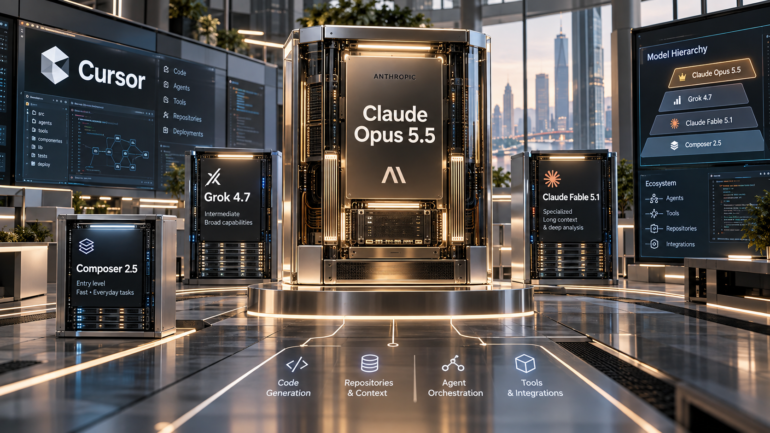
W praktyce nie ma potrzeby uruchamiania najmocniejszego modelu do każdej zmiany w projekcie. Composer 2.5 nadal pozostaje odpowiednim rozwiązaniem do zwykłego developmentu, prostych poprawek i niewielkich refaktorów, Grok 4.7 może obsługiwać trudniejsze zadania, a Opus 5.5 przejmować problemy o wysokim ryzyku regresji. Do tej ostatniej kategorii należą między innymi migracje, rozbudowane refaktory, trudne code review, audyty, projektowanie architektury oraz analiza problemów, których wcześniejsze modele nie potrafiły poprawnie zdiagnozować. Fable 5.1 może natomiast zostać zachowany jako rozwiązanie dla wyjątkowo długich i autonomicznych procesów.
Medium może okazać się najciekawszym ustawieniem
Jedną z najważniejszych obserwacji wynikających z benchmarków jest wysoka skuteczność Opus 5.5 bez uruchamiania maksymalnego reasoning. Wariant Medium osiąga 52,5% przy koszcie około 2,91 dolara na zadanie testowe, podczas gdy Max dochodzi do 57,8% przy koszcie około 13,43 dolara. Oznacza to ponad czterokrotny wzrost kosztu za dodatkowe 5,3 punktu procentowego w tym konkretnym teście. Racjonalnym podejściem staje się więc rozpoczęcie od Medium, przejście do High przy bardziej ryzykownych problemach oraz wykorzystanie Extra High lub Max dopiero wtedy, gdy niższy poziom nie wystarcza.
Efektywność staje się równie ważna jak inteligencja
Znaczenie Claude Opus 5.5 wynika z połączenia wysokiej skuteczności, niższego kosztu, ograniczonego zużycia tokenów i dopasowania do pracy z narzędziami. Model zaczyna zajmować miejsce pomiędzy ekonomicznymi rozwiązaniami do codziennej pracy a ekstremalnie drogimi modelami przeznaczonymi do najbardziej wymagających zadań. W efekcie decyzja o eskalacji nie musi już oznaczać natychmiastowego przejścia do najdroższego wariantu. Coraz większe znaczenie ma dobranie odpowiedniego poziomu reasoning do faktycznego ryzyka i skali problemu.


