Gemini 4 Carbon nowym liderem sztucznej inteligencji
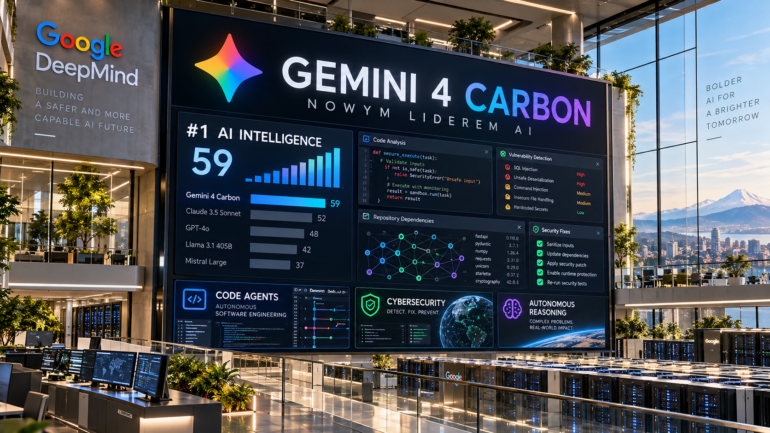
28 października 2026 roku Google DeepMind zaprezentowało Gemini 4 Carbon, najbardziej zaawansowany model AI w rodzinie Gemini 4. Według przedstawionych wyników model osiągnął 59 punktów w Artificial Analysis Intelligence Index v5.0, wyprzedzając Claude Opus 5.5, GPT-6 Astra oraz wcześniejszy Gemini 4 Argon. Najważniejsze zmiany dotyczą zaawansowanego rozumowania, autonomicznego programowania i cyberbezpieczeństwa. Nowy system ma umożliwiać realizację wieloetapowych zadań inżynieryjnych, obejmujących analizę repozytoriów, wykrywanie błędów oraz przygotowywanie i weryfikowanie poprawek. Google zapowiada również większą zgodność z instrukcjami i ograniczenie niepożądanych zachowań modelu. Premiera wskazuje na rosnące znaczenie sztucznej inteligencji, która nie ogranicza się do generowania odpowiedzi, lecz uczestniczy w całym procesie tworzenia oprogramowania.
Architektura możliwości i wyniki benchmarków
Gemini 4 Carbon obsługuje okno kontekstowe o pojemności miliona tokenów oraz multimodalne dane wejściowe, obejmujące tekst, obrazy, dźwięk i materiały wideo. W testach Terminal-Bench 4.0 uzyskał 65,2%, natomiast w GraphWalks osiągnął 96,2%, co wskazuje na wysoką skuteczność pracy z rozbudowanym kontekstem. W zestawieniu z Gemini 4 Argon, który zdobył 50 punktów w Artificial Analysis Intelligence Index, Carbon zanotował wzrost wyniku do 59 punktów. Przewaga nad Claude Opus 5.5 wyniosła jeden punkt, a nad GPT-6 Astra dwa punkty. Wynik ogólnego indeksu obejmuje różne kategorie zdolności modelu, dlatego nie stanowi bezpośredniej miary wydajności w każdym zastosowaniu. Szczególnie istotne pozostaje rozróżnienie między skutecznością w benchmarkach a praktycznymi rezultatami uzyskiwanymi podczas pracy z rzeczywistym oprogramowaniem.
Rywalizacja modeli w inżynierii oprogramowania
W testach programistycznych Gemini 4 Carbon prezentuje zróżnicowane rezultaty na tle konkurencji. W SWE-sweep uzyskał 9,6%, nieznacznie przewyższając GPT-6 Astra z wynikiem 9,5%, natomiast w FrontierSWE 2 osiągnął 61,2%, ustępując GPT-6 Astra i Claude Opus 5.5. Wyraźną przewagę Carbon uzyskał w Terminal-Bench 4.0 oraz zadaniach wymagających analizowania bardzo długiego kontekstu. Jednocześnie Artificial Analysis Coding Agent Index v2.0 przyznał 62 punkty Claude Opus 5.5 działającemu w Claude Code i 59 punktów Carbonowi w Antigravity CLI. Oznacza to, że lider ogólnego rankingu AI nie musi być jednocześnie najskuteczniejszym agentem programistycznym. Rezultaty zależą również od środowiska, konfiguracji narzędzi i sposobu wykorzystywania modelu. Wybór technologii do profesjonalnego programowania wymaga więc uwzględnienia charakteru zadań, a nie wyłącznie pozycji w pojedynczym zestawieniu.
Wielodniowa autonomia w pracy nad kodem
Jednym z najistotniejszych kierunków rozwoju Gemini 4 Carbon jest zdolność do utrzymywania ciągłości skomplikowanych procesów inżynieryjnych. Google informuje o wewnętrznych eksperymentach, podczas których model realizował zadania programistyczne przez wiele godzin, a nawet dni, analizując niepowodzenia i podejmując kolejne próby rozwiązania problemów. Taki proces może obejmować przegląd zależności, odtwarzanie błędów, lokalizowanie przyczyn, modyfikowanie kodu, uruchamianie testów oraz kontrolę regresji. Najważniejszą cechą agentowej autonomii staje się możliwość samodzielnego korygowania wcześniejszych decyzji, zamiast przerywania działania po pierwszym niepowodzeniu. Pozwala to ograniczać liczbę ręcznych interwencji podczas realizowania wieloetapowych prac. Demonstracje prowadzone w kontrolowanych warunkach nie gwarantują jednak porównywalnej skuteczności w każdym produkcyjnym repozytorium. Nadal konieczne pozostaje określenie uprawnień agenta, zasad zatwierdzania zmian oraz granic jego samodzielności.
Cyberbezpieczeństwo jako strategiczny kierunek rozwoju
Gemini 4 Carbon został szczególnie mocno ukierunkowany na zadania związane z bezpieczeństwem oprogramowania. W SEC-bench Pro uzyskał 88,2% skuteczności wykrywania podatności, w ExploitGym osiągnął 54,8%, natomiast w CWE-bench zanotował 71% w zadaniach naprawiania luk. Największy wzrost względem Gemini 4 Argon odnotowano w ExploitGym, gdzie różnica wyniosła 12,8 punktu procentowego. Google informuje ponadto o ponad dwukrotnym zwiększeniu skuteczności generowania bezpiecznego kodu w wewnętrznych testach. Rozwój takich możliwości może umożliwić łączenie analizy zagrożeń, weryfikacji podatności i przygotowywania poprawek w jeden proces agentowy. Automatyzacja audytów bezpieczeństwa może znacząco usprawnić utrzymywanie rozbudowanych aplikacji, szczególnie tych rozwijanych przez wiele lat. Wyniki benchmarków nie oznaczają jednak gwarancji wykrycia wszystkich zagrożeń ani wyeliminowania konieczności niezależnej weryfikacji.
Wiarygodność odpowiedzi i odporność na manipulację
Ważnym elementem rozwoju Carbona jest ograniczanie błędów wynikających z nieprawidłowego interpretowania instrukcji i generowania niepotwierdzonych informacji. Według wewnętrznych ocen Google liczba nieuzasadnionych twierdzeń zmniejszyła się około dwukrotnie względem Argona, a liczba alarmów dotyczących poważnych niepożądanych zachowań spadła o niemal 80%. Odnotowano również ograniczenie nadmiernego wychodzenia poza zakres zadania o 26% oraz przypadków pomijania wymaganych działań o 29%. W wybranych testach prompt injection nie stwierdzono skutecznych ataków, co nie oznacza pełnej odporności modelu na manipulację. Niezależny benchmark AA-Omniscience v1.1 wykazał jednocześnie 11% halucynacji Carbona wobec 4% Argona, pomimo wyższej ogólnej skuteczności nowszego modelu. Rzetelność działania pozostaje zatem zależna od rodzaju testu i konkretnego zastosowania. Dla profesjonalnej inżynierii oprogramowania szczególnie ważna staje się zdolność sygnalizowania niepewności, respektowania ograniczeń i unikania nieautoryzowanych zmian.
Możliwe zastosowania w Cursor IDE
Możliwości Gemini 4 Carbon wskazują na potencjalną przydatność w zaawansowanych środowiskach programistycznych, takich jak Cursor IDE. Analiza dużych repozytoriów, rozwiązywanie trudnych regresji, wieloetapowe audyty i niezależne code review należą do zadań, w których rozbudowany kontekst oraz zdolności rozumowania mogą mieć istotne znaczenie. Carbon mógłby również wspomagać kontrolę bezpieczeństwa zależności, analizę błędów TypeScript i refaktoryzację złożonych aplikacji Angular lub .NET. Na 30 października 2026 roku nie potwierdzono jednak publicznej dostępności tego modelu w Cursor IDE. Nie wykazano również jednoznacznej przewagi Carbona nad Claude Opus 5.5 lub Claude Fable 5.1 w rzeczywistym środowisku Cursor. Ewentualne wdrożenie wymagałoby oceny jakości analizy, kosztów, szybkości działania oraz skuteczności wykrywania regresji. Szczególnie wartościowe mogłoby być wykorzystanie modelu do niezależnej weryfikacji zmian wykonywanych przez inne systemy AI.
Koszty API i efektywność ekonomiczna
Google przedstawiło promocyjny cennik Gemini 4 Carbon obejmujący 2 USD za milion tokenów wejściowych oraz 10 USD za milion tokenów wyjściowych. Standardowe stawki mają wynosić odpowiednio 4 USD i 20 USD, a koszt odczytu danych z cache określono na 0,10 USD w promocji i 0,20 USD poza nią. Niższa cena jednostkowa może zwiększać atrakcyjność Carbona wobec kosztownych modeli konkurencji, ale nie przesądza o całkowitym koszcie realizacji zadania. Według Artificial Analysis średni koszt zadania w Intelligence Index przy standardowych cenach wyniósł 7,76 USD dla Carbona, 7,68 USD dla Argona, 6,25 USD dla GPT-6 Astra oraz 10,04 USD dla Claude Opus 5.5. Carbon osiągnął więc istotnie wyższy wynik ogólny od Argona przy zbliżonym koszcie zadania. W praktyce ekonomicznej znaczenie mają także liczba podejmowanych prób, długość procesu rozumowania, wykorzystanie narzędzi i konieczność ponawiania testów. W środowiskach takich jak Cursor IDE dodatkowym czynnikiem pozostaje sposób rozliczania modeli zewnętrznych w ramach poszczególnych subskrypcji.
Nowy model odpowiedzialności za proces programowania
Rozwój Gemini 4 Carbon odzwierciedla zmianę sposobu wykorzystywania AI w inżynierii oprogramowania. Zamiast ograniczać zastosowanie modeli do generowania pojedynczych funkcji, coraz częściej przewiduje się powierzanie agentom AI całych procesów analizy, implementacji, testowania i naprawiania kodu. W takim podejściu rośnie znaczenie planowania etapów, kontrolowania uprawnień i sprawdzania poprawności rezultatów. Programista może stopniowo przejmować rolę osoby zarządzającej pracą wyspecjalizowanych agentów, zamiast samodzielnie wykonywać każdą operację techniczną. Kluczowym warunkiem bezpiecznej autonomii pozostaje zachowanie ludzkiej kontroli nad decyzjami o wysokim ryzyku regresji. Nawet zaawansowany model może bowiem zaproponować zmianę technicznie poprawną, ale niezgodną z architekturą systemu lub wymaganiami projektu. Z tego względu automatyczne testy, niezależne code review i jasno określone kryteria akceptacji nadal stanowią podstawę odpowiedzialnego wykorzystania agentów AI.